造一个翻译官
机器只懂数字,人只擅长想法,中间隔着一道大坑。 汇编器先把好念的短名字变成数字,编译器再把接近人话的语言变成数字。 而翻译官自己也是程序——这句话马上会把我们带进一个很有意思的坑。
先感受一下“没有翻译官”的痛
假设机器的一条指令是 8 位:前 4 位表示“干什么”,后 4 位表示“对哪个位置干”。 那么“把一个数加 4,然后打印出来”,在机器里就是这样的数字:
9 03 A 04 7 00 0 00
你得背下来:9 是“装一个数进来”,A 是“加上一个数”,7 是“打印”,0 是“停机”。
数字和含义之间没有任何提示,写错一位,程序就跑到别的地方去了。
人的脑子不擅长记编号,擅长记名字。那能不能让机器来查表——我们写名字,它翻成数字? 能。这就是翻译官诞生的原因。
第一步:给数字起名字 —— 汇编器
- 用短名字代替数字:
LDA(load into accumulator,装进累加器)、ADD、JMP(jump,跳转)。这种短名字叫助记符(mnemonic)。 - 再写一个小程序,专门负责把
LDA 12这样的字翻译成1 C这样的数字。这个程序叫汇编器(assembler)。 - 它还会帮你算地址:你给某一行起个名字(标签),汇编器自动算出它到底在哪个地址,不用你数格子。
时间线上有两个名字值得记住:
- 1947 — 1949 年,Kathleen Booth 为 ARC2 机器写了最早的汇编器之一,还设计了配套的指令。
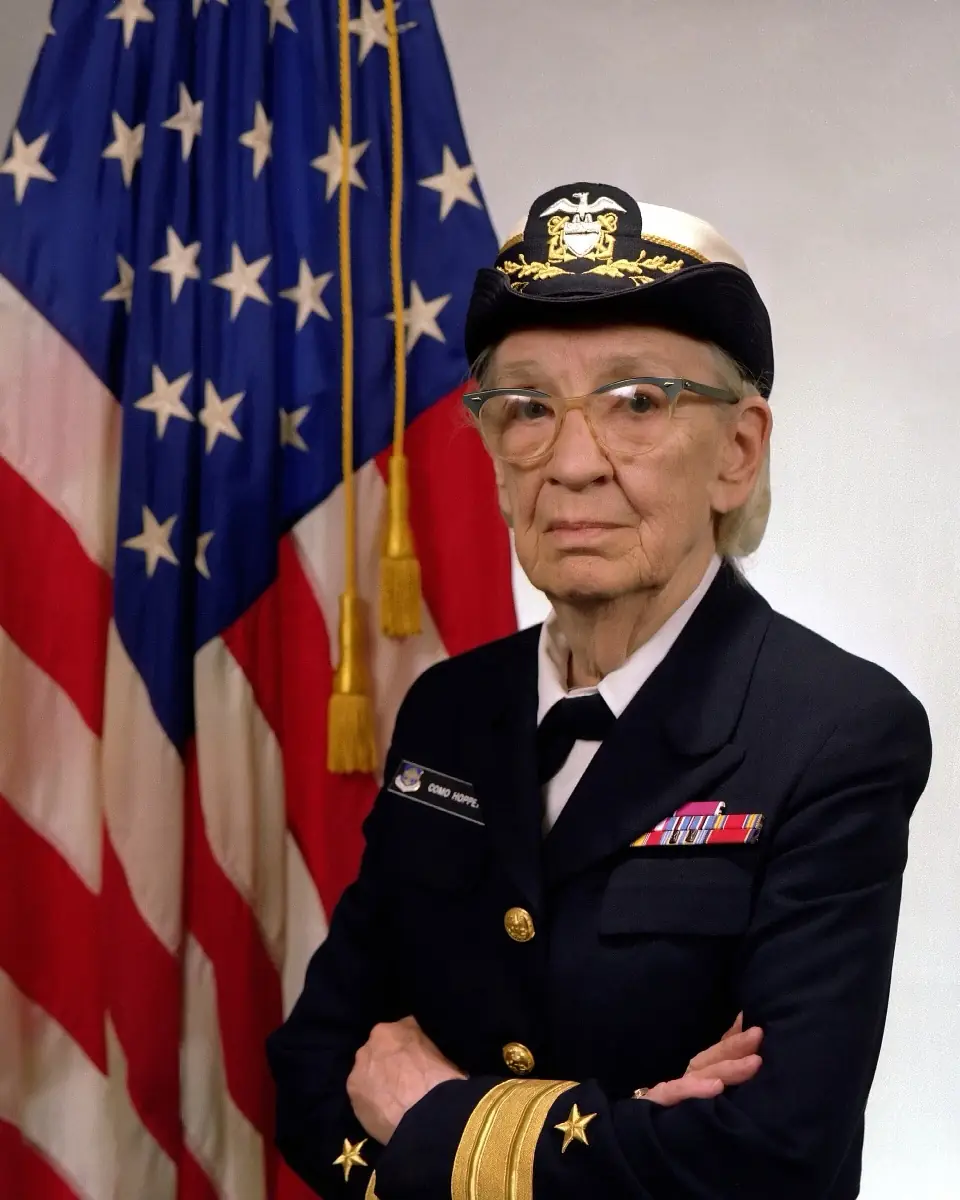
- 1952 年,Grace Hopper 的 A-0 系统走得更远:她把“让机器来翻译程序”这件事做成了系统,并让 compiler(编译器)这个词流行起来。当时有人跟她说“机器不能自己写程序”,她的态度是:那就先给它写一个。
收益有多大?翻译这件苦活只干一次——造出汇编器以后,每天写程序都省力。 这也是编程史上第一个“磨刀不误砍柴工”的决定。
第二步:让机器读人话 —— 编译器
汇编语言还是一条对一条的,长得跟机器指令很像。人们想要的是直接写:
A = 3 + 4
1957 年,FORTRAN(FORmula TRANslation,公式翻译)在 IBM 704 上诞生,John Backus 的团队为它工作了大约六年。
当时很多专家并不相信机器能翻译出好代码,认为编译出来的程序一定比人手写的汇编慢一大截。 结果 FORTRAN 编译出来的代码几乎和手写汇编一样快,还会做优化。 “你可以写得像人话,跑得像手写”——编译器的信用,就是从这一刻建立起来的。
接着语言一个接一个出现:
- 1958 年 LISP(John McCarthy):用括号和列表描述计算。它有一个了不起的性质——它的求值器可以用 LISP 自己写。这是第 4 站的伏笔。
- 1959 年 COBOL:面向商业和数据处理,句子长得像英语,一直用到现在(银行和保险系统里还藏着很多)。
- 1960 年 ALGOL:第一个被认真设计、有清晰语法报告的语言。后来几乎所有语言的“句型”,都能看到它的影子。
编译器 和 解释器,有什么不同?
- 编译器像把整本书先翻译好,再交给读者:一次性把你的程序翻译成机器码,之后直接跑翻译结果,速度快。
- 解释器像同声传译:读一句、翻一句、执行一句,改起来方便,但通常慢一些。
- 两种都能用,很多现代语言两者结合(比如先编译成一种中间形式,再解释或即时编译)。
于是有了一座“一层叠一层”的塔
塔的每一层都是程序,而这些程序又是用塔下面的一层写出来的。 那么问题来了:最下面那一层的程序,是谁写的?
如果第一个汇编器是用汇编语言写的,会出什么事? (提示:你得先有一个汇编器,才能把汇编器汇编出来。) 这个死循环有一个漂亮的名字,也有好几种破解办法——下一站见。
小结
翻译官把写程序的成本降低了几百倍:人只写想法,机器负责把它变成数字。 但它顺手留下了一个难题——翻译官自己也得有人写。 这个难题的名字,叫自举。