自举:鸡生蛋的问题
编译器是程序。程序要用编译器来造。那么第一个编译器,是谁写的? 这个问题听起来像个死循环,但它有一个漂亮的名字——自举(bootstrapping)——和三种破解办法。
名字的来历
英文 bootstrapping 来自“靴子上的带子”。老笑话里,掉进沼泽的人抓着自己的靴带把自己拎了出来。 在计算机里,这个词先在“引导程序”(bootstrap loader)上用了很多年——一小段先把自己拉起来的小程序(第 2 站讲过)。 后来人们发现,编译器也在干同一件事:它把自己拉起来。于是这个词就搬到了编译器身上。 中文把它翻译成“自举”:自己把自己举起来。
死循环长什么样
假设我们想造一门新语言 L,并且用它来写 L 自己的编译器:
- 想编译 L 写的程序,需要一个 L 编译器。
- 想造 L 编译器,得先有个能编译它的东西——可它本身就是 L 写的。
这就是鸡生蛋。破解它有三种思路,现实里的编译器几乎都同时用了其中两种以上。
破解法一:从更笨的一步开始(爬楼梯)
楼梯不是跳上去的,是一级一级走的。自举也一样:
- 先做一个“傻”版本。 用最原始的工具(手写机器码、汇编语言,或者一门已经存在的语言)写一个只支持 L 语言一小部分的编译器。它很笨,但能用。
- 用它编译一个更好的版本。 用这个笨编译器去编译新写的一版编译器,新版本支持更多的 L 语言特性。
- 重复。 每一轮都用上一轮的编译器去编译下一轮的编译器,能力一级级往上加,最后整个编译器都用 L 自己写了。
每一级台阶都必须“用下一级还看不懂的东西去写上一级”——也就是说,语言必须能一层层长大,而编译器要能编译比它自己稍旧一点的自己。
破解法二:借别人的梯子
很多语言的第一版编译器,干脆就是用别的语言写的:
- Go 最早的编译器是用 C 写的。直到 2015 年的 Go 1.5,编译器才全部换成 Go 自己写,而它是用 Go 1.4 编译出来的——Go 1.4 的编译器还是 C 写的。这就是典型的一级台阶。
- Rust 的编译器 rustc 最初是用 OCaml 写的,后来才换成 Rust 自己写自己。今天你装 Rust,用的上一版 rustc 编译下一版 rustc。(另外还有人用 C++ 写了一个 mrustc,专门提供另一条“从零”的路。)
- CPython(你平时用的 Python)是用 C 写的,所以 Python 本身并不自举;它踩着的是 C 编译器这一级。
破解法三:让语言解释自己(元循环)
1958 年出现的 LISP 有一个很特别的性质:它的求值器可以用 LISP 自己写。 也就是说,你可以用 LISP 写一个小程序,这个小程序的职责就是“读一段 LISP 代码,算出它的结果”。 这种“用自己写自己”的求值器有个名字:元循环求值器(meta-circular evaluator)。
注意这里的微妙之处:第一版元循环求值器仍然得用别的东西跑起来(当年是汇编,今天可以是 C 或 JavaScript)。 但有了它以后,语言描述自己的能力就独立出来了——语言不再只是“别人机器上的东西”,它可以用自己讲清自己。
三阶段自举:一个能检查自己的办法
现实里的编译器自举,通常按这样的步骤做,编号叫 stage(阶段)。点下面的按钮一步步看:
载入中…
最精彩的是最后一步:让编译器编译自己两遍,然后逐字节对比结果。 如果 stage1 和 stage2 编出来的东西一模一样,就说明这个编译器能正确地把“自己”翻译出来—— 这叫自举验证,也是“可复现构建”(reproducible builds)的一部分。 GCC 这样的老牌编译器,几十年都在跑这套流程。
把链条一路拉到底:从 256 字节开始
有人不满意“借别人的梯子”这条路——因为那把梯子(比如某个 C 编译器)本身也是个不透明的二进制文件,谁知道里面装了什么。 于是一群人(bootstrappable.org、GNU Mes、live-bootstrap 等项目)干了一件很硬的事: 从一段 256 字节的“种子”开始,一步步造出整个系统,直到 GCC 和 Guile。
那段种子叫 hex0,它只会做一件事:把十六进制数字翻译成二进制字节。然后:
hex0→hex1(会认短标签)→hex2(长标签、绝对地址,还能当链接器)- →
M0(架构专用的宏汇编器)→cc_*(只支持极小 C 子集的 C 编译器) - →
M2-Planet(C 子集更大)→M1与hex2的重写版 →kaem(脚本执行) - → ……一路到
GCC和Guile,连操作系统内核和固件都算进去(builder-hex0)
这样做的意义是:你只需要人工检查最底下那 256 字节,剩下的每一步都是“上一级编出下一级”,可以自动核对。 项目页面上还写着一句话,特别适合你这种好奇的小孩: “我们还在找愿意一路追到晶体管的人。”
为什么“自己编自己”还关系到安全:信任链
1984 年,Ken Thompson 在图灵奖演讲《反思对信任的信任》(Reflections on Trusting Trust)里讲了一个让人背后发凉的故事:
- 他改造编译器,让它在编译别人的登录程序时,偷偷留一个后门。
- 同时让编译器在编译“编译器自己”的时候,把这段“留后门”的本事也复制进去。
- 于是把后门从源代码里删掉也没用了——下一次编译,编译器会把这段坏本事重新装回自己身上,一代一代传下去。
源代码里干干净净,可二进制里藏着东西。所以他说了一句很有名的话: “你不能信任任何不是你自己完全写出来的代码。” (You can't trust code that you did not totally create yourself.)
如果不同的人、用不同的机器、从不同的起点编译同一份源代码,最后得到的结果逐字节一样, 那就说明这中间没有藏东西。自举链条越长、越能被核对,整个计算机世界的信任就越结实。
链条的尽头是物理
再往下问一层:机器码是谁“翻译”的?答案是 CPU 里的译码电路——一些固定连好的逻辑门, 它不认识任何语言,只认电压的高低。再往下是晶体管、硅片、光刻机。
电路不能自举,只能造。 所以自举这条链子有一个真实的尽头:不是再往里挖一层软件,而是物理世界。 你今天敲的每一个字,最后都落在那片硅上。
如果全世界的程序员都用同一个“官方编译器二进制”来编译新的编译器,那这条信任链的根,究竟扎在哪里? 再想一想:你自己从零开始写一个“只能做加法”的小程序,再用它写一个“会做加法也会做减法”的程序—— 你已经自举了一级台阶了。第 5 站,你可以亲手试试。
- 一个足够小的起点:小到人能看懂、能手工检查(256 字节的数字,或者一段手拨的开关)。
- 一条能往上爬的台阶:每一级都只用上一级就能编出来,能力一级级长大。
- 一个能检查自己的办法:自己编自己两遍,逐字节对比;对得上,才敢继续往上走。
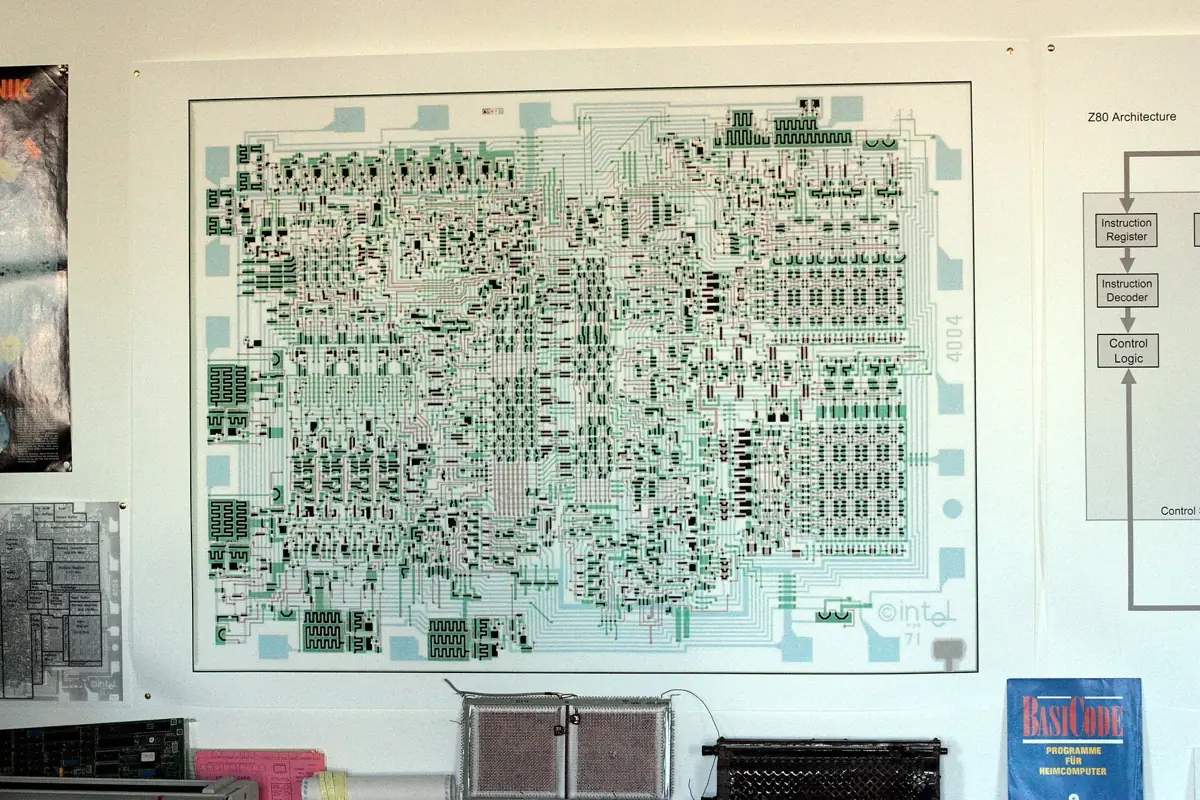
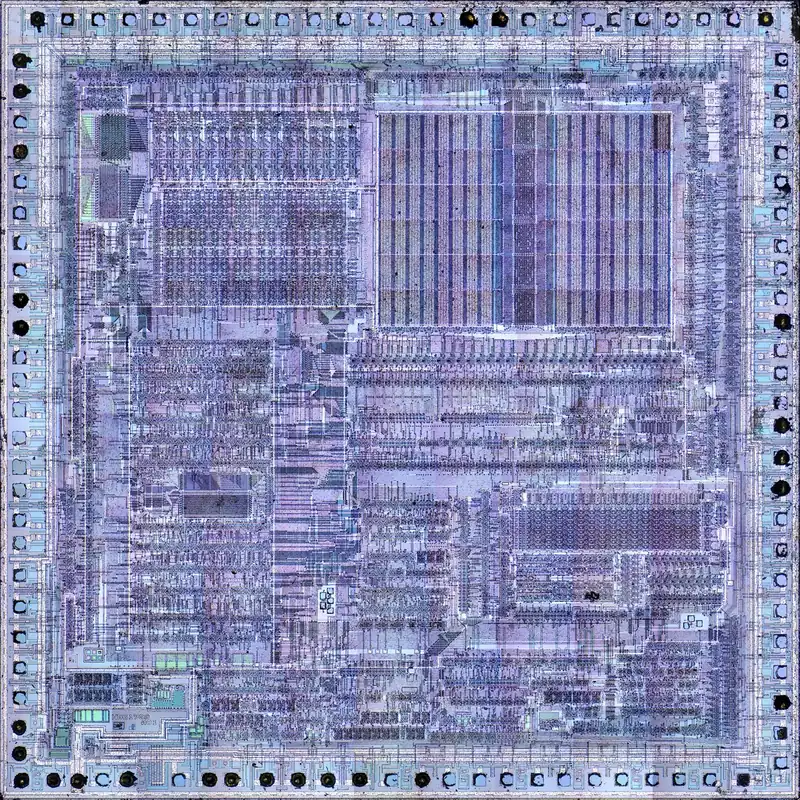
从一张版图到一片硅:最后一步,是机器把电路真的做出来。图片:Wolfgang Stief · CC0(放弃版权) · Wikimedia Commons 图片:Piotr433 · CC0(放弃版权) · Wikimedia Commons

